- explainer
- データサイエンス
- AI
決定木とは?業務で試す前に押さえる仕組みと過学習の確かめ方
決定木は条件の枝分かれで予測する仕組みです。分類と回帰の違い、学習用データとテストデータを分ける理由、過学習を抑える設定、初めて試すときの手順と確認事項をまとめます。
この記事で分かること
決定木(条件の枝分かれで結論を出す予測の仕組み)を、業務で試す前に確かめる手順。
結論
当てたいのがグループか数値かを決め、データを作る用と確かめる用に分けたうえで、確かめる用のデータで成績が落ちないことを見てから業務に使います。
この記事の目次
こんなときに役立ちます: 問い合わせの優先度を決める筋道を共有したいとき
(仮想シナリオ)営業企画の担当者が、過去の問い合わせ記録をもとに、どの問い合わせから折り返すかを決めたいと考えています。ところが今は担当者ごとに優先度の付け方が違い、なぜその順番にしたのかを誰も説明できません。
問い合わせの経路や内容で枝分かれする決定木を作ると、優先度を決める筋道が一枚の図になります。どの条件が結論を左右しているのかをチームで見比べられるので、判断がずれている箇所や、見直したい条件を話し合う材料が手に入ります。担当者の頭の中にあった基準を、条件の並びとして外に出せることが、試してみる理由です。
| 困りごと | 解決できること |
|---|---|
| 担当者ごとに優先度の付け方がばらつく | 優先度を決める筋道を 1 枚の図にしてチームで共有できる |
| なぜその順番にしたのかを説明できない | どの条件が結論を決めたのかを、根から葉までたどって示せる |
| どの基準を見直せばよいか分からない | 判断がずれている条件を特定し、見直しの話し合いの材料にできる |
背景:決定木は判断の筋道が見える一方、手元のデータに合わせすぎやすい
決定木は、データの条件を「はい・いいえ」で順に問いかけ、たどり着いた先で予測を出します1。途中の判断を人が目で追えることが、決定木の大きな特徴です2。その反面、条件を細かくしすぎると、手元のデータに合わせすぎて新しいデータでは外れる状態になります。これを過学習と呼びます3。過学習した木は手元のデータで高い成績を出しても新しいデータには通用しないため、気づかないまま業務に持ち込むと実際の判断で外れが増えます4。
過学習を業務の前に見抜くために、着手前に次の 3 つを決めておくことをおすすめします。
- 何を当てたいか。どのグループに当てはまるかを当てること(分類)なのか、金額や件数などの数値を当てること(回帰)なのかで、木の作り方も評価の仕方も変わります。
- データをどう分けるか。予測のルールを作るのに使うデータ(学習用データ)と、作ったルールが新しいデータでも当たるかを確かめるために取り分けるデータ(テストデータ。この記事では確認用データとも呼びます)を、最初に分けておきます。
- 何で確かめるか。木の作り方は学習用データの中で交差検証をして調整し、最後にテストデータで、成績が学習用データより大きく落ちていないかを確かめます。
決定木は根から葉まで条件をたどって予測する
決定木は、最初の問いから順に条件をたどり、行き着いた先に置かれた予測を答えにします1。木の部分は根・節・葉の 3 つに分かれ、それぞれ役割が違います。
| 部分 | 役割 | 問い合わせ優先度の例(仮想シナリオ) |
|---|---|---|
| 根 | 最初の問いを置く | 問い合わせ経路は電話か |
| 節 | 条件で枝分かれする途中の問いを置く | 内容は解約に関するものか |
| 葉 | 最終的な予測を置く | 優先度:高 |
節ごとに選ばれるのは、手元のデータをできるだけきれいに 2 つのグループへ分けられる条件です5。分け方の良し悪しは「不純度」という指標で測ります。不純度は、分けた後のグループに違う結論がどれだけ混ざっているかを表し、小さくなる条件ほど良い分け方とみなされます6。
枝分かれは際限なく続くわけではありません。木の深さの上限や、1 つの節に残すデータの最小件数に達したところで分割を止め、葉が決まります5。根から葉までたどった道筋がそのまま図に残るので、なぜその優先度になったのかを、担当者以外にも説明できます1。
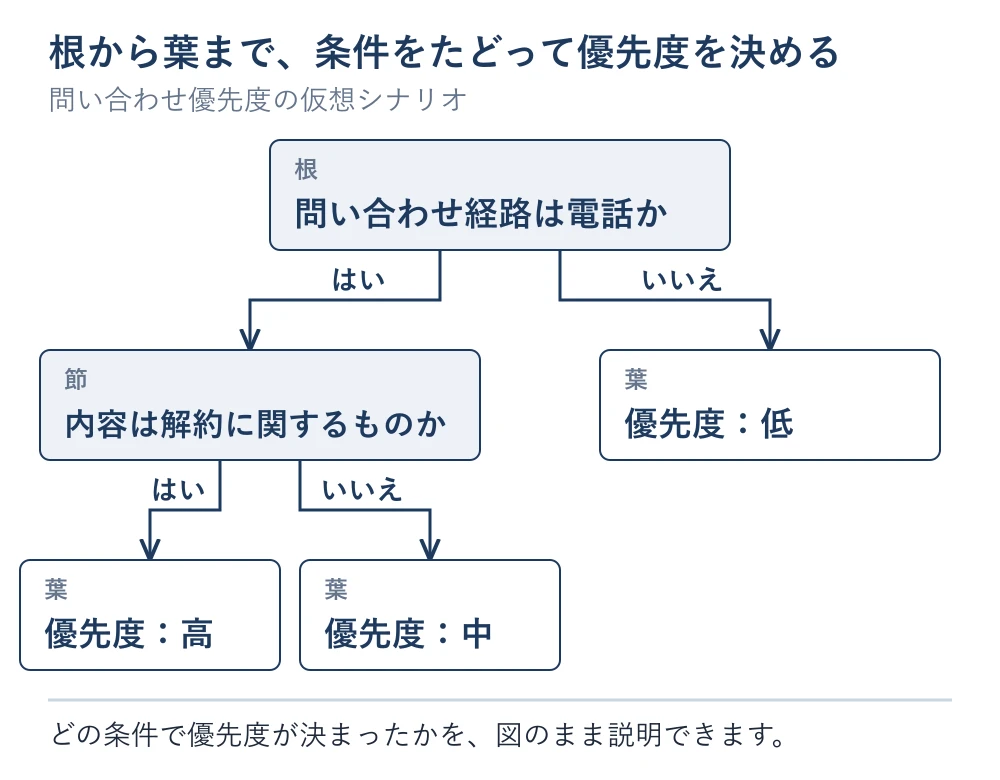
図1 問い合わせの優先度を決める決定木の例(編集部作成の概念図)。 出典: 本文の仮想シナリオを基にした SignaRoot 編集部の説明図
根の条件から順にたどり、たどり着いた葉の優先度が予測になります。たどった道筋が、そのまま判断の説明になります。
分類と回帰の違いは葉に置く予測の種類にある
分類の木は葉に「優先度:高」のようなグループを置き7、回帰の木は葉に具体的な数値を置きます8。葉に置くものが違うと、分け方の測り方も、出来上がった木の評価の仕方も変わります9。
| 観点 | 分類 | 回帰 |
|---|---|---|
| 葉に置く予測 | グループ(クラス) | 数値 |
| 分け方の良し悪しの測り方 | 不純度(混ざり具合) | グループ内の数値のばらつき |
| 主な評価の指標 | 正解した割合など | 予測値と実際の値の差 |
問い合わせ優先度の仮想シナリオは、「高・中・低」のどれに当たるかを当てるので分類です。同じ記録から「折り返しまでに何分かかりそうか」を予測したいなら、回帰になります。同じデータでも、何を当てたいかで木の作り方が変わるため、ここは着手前に決めてください7。
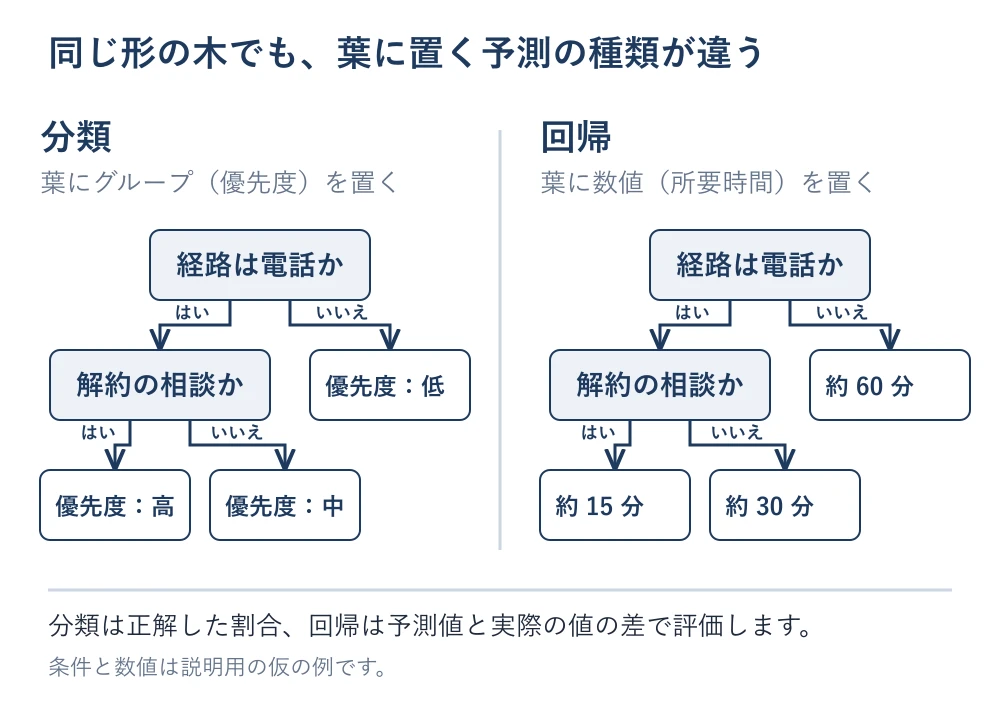
図2 同じ形の木で比べた分類と回帰の違い(条件と数値は仮の例。編集部作成の概念図)。 出典: 本文の仮想シナリオを基にした SignaRoot 編集部の説明図
木の形が同じでも、分類はグループを、回帰は数値を葉に置きます。何を当てたいかで、どちらを使うかが決まります。
学習用データと確認用データを分けるのは過学習を見抜くため
学習用データだけで成績を測ると、過学習した木でも満点に近い結果が出てしまいます4。木を複雑にするほど学習用データには合っていきますが、それは学習用データを丸暗記しているだけで、新しいデータでは外れる場合があるからです3。
そこで、木を作る学習用データとは別に、確かめるためのテストデータを取り分けます。テストデータは学習の途中では一切使わず、木が完成してから初めて評価に使います10。
| データ | 使う時点 | 役割 |
|---|---|---|
| 学習用データ | 木を作るとき | 条件と分け方を決める |
| テストデータ(確認用データ) | 木が完成した後 | 新しいデータでも当たるかを確かめる |
2 つの成績を並べて、テストデータの側が大きく落ちていれば、過学習が起きていると判断できます。
1 回の分け方だけでは、簡単なデータがたまたまテスト側に集まる、といった偶然に結果が左右されます。データを複数に分け、確認に使う部分を入れ替えながら成績を確かめる方法を交差検証と呼び、何回分かの結果を平均することで、分け方の偶然による誤差を小さくできます11。例えばデータを 4 つに分けたなら、確認用を 1 つずつ入れ替えて 4 回評価し、その平均を見ます。
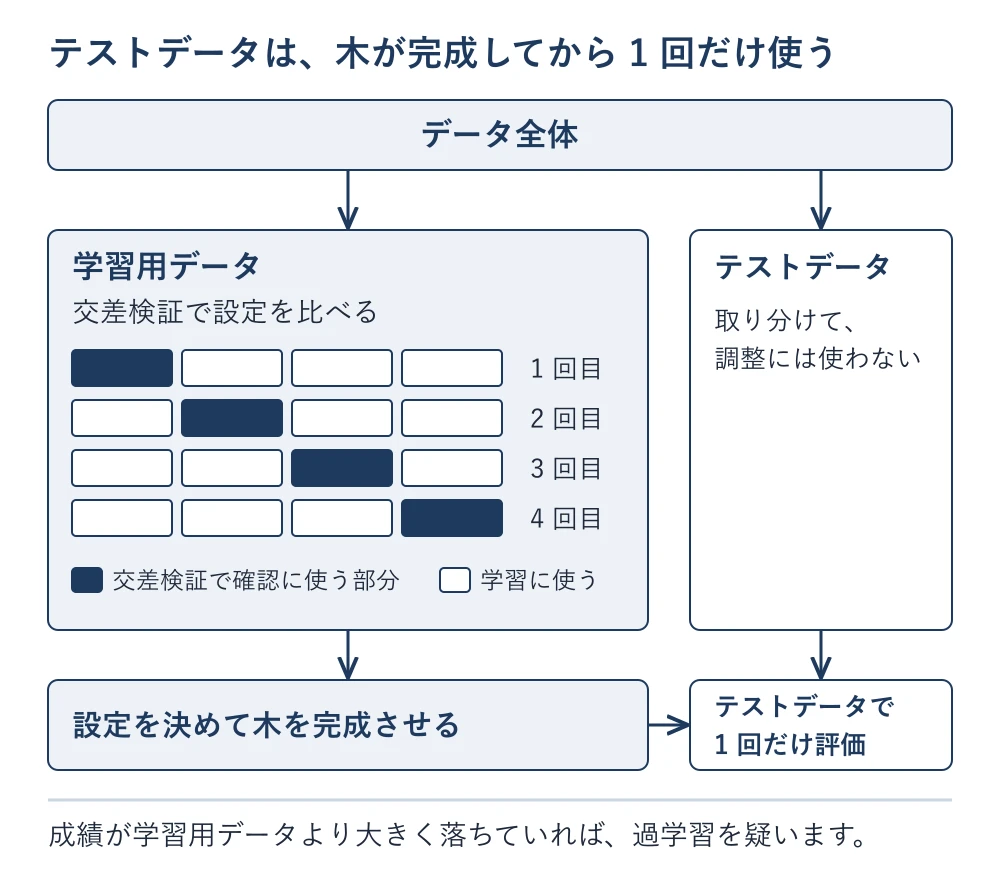
図3 交差検証とテストデータの使い分け(編集部作成の概念図)。 出典: 本文の説明を基にした SignaRoot 編集部の説明図
設定の調整は学習用データの中の交差検証で済ませ、テストデータは完成した木の評価に 1 回だけ使います。
決定木の過学習は木の深さと葉の大きさを制限して抑える
過学習を抑える手段は、主に次の 3 つです。どれも、木が細かくなりすぎるのを止めるためのものです。
| 手段 | 何を制限するか | 防ぎたいこと |
|---|---|---|
| 木の深さの上限 | 根から葉までの分岐の回数12 | 条件が細かくなりすぎる |
| 葉に必要な最小データ数 | 1 つの葉を作るのに要るデータの件数13 | ごく少数のデータだけで葉ができる |
| 剪定 | いったん大きく育てた木のうち、精度への影響が小さい枝2 | 役に立たない枝が残る |
ただし、制限を強めすぎると、今度は必要な条件まで見落とします。深さの上限を厳しくしすぎたり、葉の最小データ数を大きくしすぎたりすると、学習用データでの成績そのものが下がるからです。調整は、学習用データの中で交差検証をしながら決めます。テストデータを調整に使うと、テストデータの結果が調整に漏れ込み、最後の確認の意味がなくなるため、テストデータは最後まで取っておきます11。
もう 1 つ知っておきたいのが、データが少し変わるだけで木の形が大きく変わりやすい、という弱点です2。仮想シナリオでいえば、ある月の記録を少し入れ替えただけで、根に置かれる条件そのものが変わることもありえます。制限や剪定を組み合わせるのは、この不安定さを前提に木を扱うためです。
初めて試すときの準備・手順・確認事項
初めて決定木を試すときは、準備・手順・確認の 3 段階で進めます。
準備では、まず何を当てたいかをはっきりさせ、分類か回帰かを決めます。データを用意するときは、条件に使う項目の数に対して件数が足りているかを見てください。件数が少なすぎると、過学習が起きやすくなります14。分類なら、当てたいグループの偏りも確認します。あるグループのデータが極端に少ないと、予測が多いグループに偏ることがあるためです14。
手順は、浅い木から始めるのがおすすめです。最初は深さを 3 程度にして木を図で確かめ、データへの当たり具合をつかんでから少しずつ深くします15。どの設定がよいかは、候補を交差検証で比べて選びます10。
確認では、調整を終えた木をテストデータで評価し、成績を必ず見ます。全体の成績に加えて、どのグループや条件のあたりで間違いが多いかという偏りまで見ておけば、間違いが集中しやすい箇所の見当を付けられます16。
着手の前後で、次の項目を確認してください。
- 当てたいものが分類か回帰かを決めた
- 条件に使う項目の数に対して、データの件数が足りているかを確認した
- 分類の場合、当てたいグループの偏りを確認した
- 学習用データとテストデータを分けた
- 浅い木から始め、深さや葉の最小データ数を交差検証で少しずつ調整した
- テストデータでの成績と、間違いの偏りを確認した
データサイエンスに関する記事は、データサイエンスの記事一覧にまとめています。
参考文献
-
Decision trees | Machine Learning | Google for Developers、DecisionTreeClassifier ↩ ↩2 ↩3
-
1.10. Decision Trees、Overfitting | Machine Learning | Google for Developers ↩ ↩2 ↩3
-
3.1. Cross-validation: evaluating estimator performance ↩ ↩2
-
DecisionTreeRegressor、1.10. Decision Trees、Decision trees | Machine Learning | Google for Developers ↩ ↩2
-
DecisionTreeRegressor、3.1. Cross-validation: evaluating estimator performance、1.10. Decision Trees ↩
-
3.1. Cross-validation: evaluating estimator performance ↩ ↩2
-
3.1. Cross-validation: evaluating estimator performance ↩ ↩2
-
Post pruning decision trees with cost complexity pruning、1.10. Decision Trees ↩
-
Post pruning decision trees with cost complexity pruning、1.10. Decision Trees ↩
更新履歴
- 公開