- 研究レビュー
- シリーズ:最新研究・技術動向
- AI
ハルシネーション対策と、生成 AI の出力の確かめ方
ハルシネーション対策として、問題文に関係の無い一文を足すと生成 AI の正答率が大きく下がり、「無視して」と書くと下がり方が和らいだ ICML 2023 の研究を数字で紹介します。出力を元の資料と照らす手順と確認表も示します。
この記事の目次
生成 AI には、問いに関係する資料だけを渡します。関係の無い一文を足すと正答率が大きく下がり、「無視して」と指示に書くと下がり方が和らいだ研究があります1。それでも誤りは残るので、出力の数値・固有名詞・日付・出典は元の資料と照らしてから使います。
こんな困りごとはありませんか
 図 1 規程をまるごと渡したら、下書きの締め切りが規程と違っていた
以下は仮想シナリオです。総務の担当者が、就業規則と関連する規程をまとめて生成 AI に貼り付け、社員向けの案内を作らせました。下書きは読みやすいのに、申請の締め切りが規程と違っていました。
- 生成 AI の誤りをどこまで減らせるのかが分からない
- 資料を多めに渡せば正確になるのか、逆なのかが分からない
- 出力のどこを確かめればよいかが決まっていない
この記事では、関係の無い情報が答えを崩すことを示した研究と、出力を確かめる手順を紹介します。
この研究は何を調べたのか
問題文に、解くのに使わない一文を足すと、答えがどれだけ崩れるかを調べました。
ハルシネーションは、生成 AI が、もっともらしいが事実や渡した資料と違う内容を答えることです。生成 AI の中心にある大規模言語モデルは、渡された文章をもとに答えを組み立てます。そのため、渡す文章の中身が答えを左右します。
取り上げるのは、2023 年の ICML(機械学習の国際会議)で発表された研究です1。算数の文章題に関係の無い一文を足した問題集(GSM-IC)を作り、モデルに解かせました1。
たとえば、りんごの残りの数を問う問題に「隣の家では犬を飼っています」と足すような形です。この例は編集部が作ったもので、論文の問題ではありません。
測ったのは算数の正答率で、ハルシネーションそのものではありません。ただし、誤りが増える仕組みを考える手がかりになります。
関係の無い情報が混じると、正答率は大きく下がる
関係の無い一文を足すだけで、正答率は 17〜29 ポイント下がりました1。
論文の結果から、当時の言語モデルの 1 つ(code-davinci-002)の正答率を抜き出しました1。「元の問題」は一文を足す前の 100 問、ほかの列は一文を足した問題での値です1。
| 解かせ方 | 元の問題 | 一文を足した問題 | +「無視して」 |
|---|---|---|---|
| 解き方の例を見せる | 95.0% | 72.4% | 77.8% |
| 小さな問いに分けて解かせる | 94.0% | 77.5% | 80.6% |
| 計算をプログラムで書かせる | 83.0% | 54.4% | 56.7% |
どの解かせ方でも、一文を足すと正答率が下がりました。よくあった誤りは、関係の無い一文の数字を計算に使ってしまうものです1。
業務でいえば、規程の束や過去のメールをまとめて渡すほど、問いと関係の無い部分も増えます。渡す量を増やすほど正確になるとは限りません。
無関係な情報を無視するよう指示すると、下がり方は和らぐ
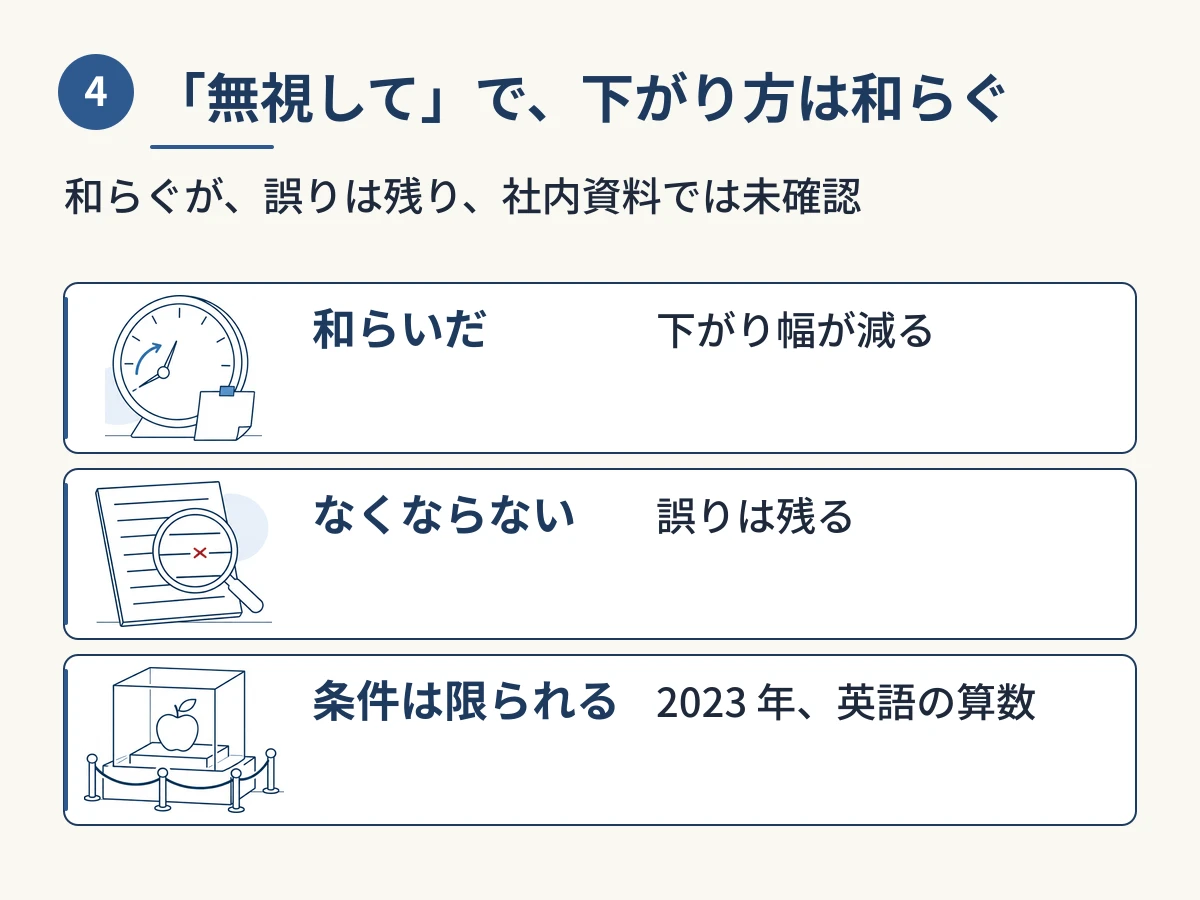
指示に一文を足すと正答率は持ち直しましたが、元の問題の水準には戻りませんでした。
研究チームは、指示の冒頭に「問題文の関係の無い情報は無視してかまいません」という趣旨の一文を加えました1。前の節の表の右端の列が、その結果です。
指示の書き方だけで試せるので、新しい仕組みを入れなくても始められます。一方で、この研究からまだ言えないこともあります。
- 和らいだだけで、誤りがなくなったわけではない
- 測ったのは英語の算数の文章題で、社内規程や議事録で同じ効き目かは分からない
- 2023 年のモデルでの結果で、今のモデルで同じになるかは分からない1
生成 AI の出力の確かめ方
渡す資料を絞り、指示に一文を足し、出力を元の資料と照らします。
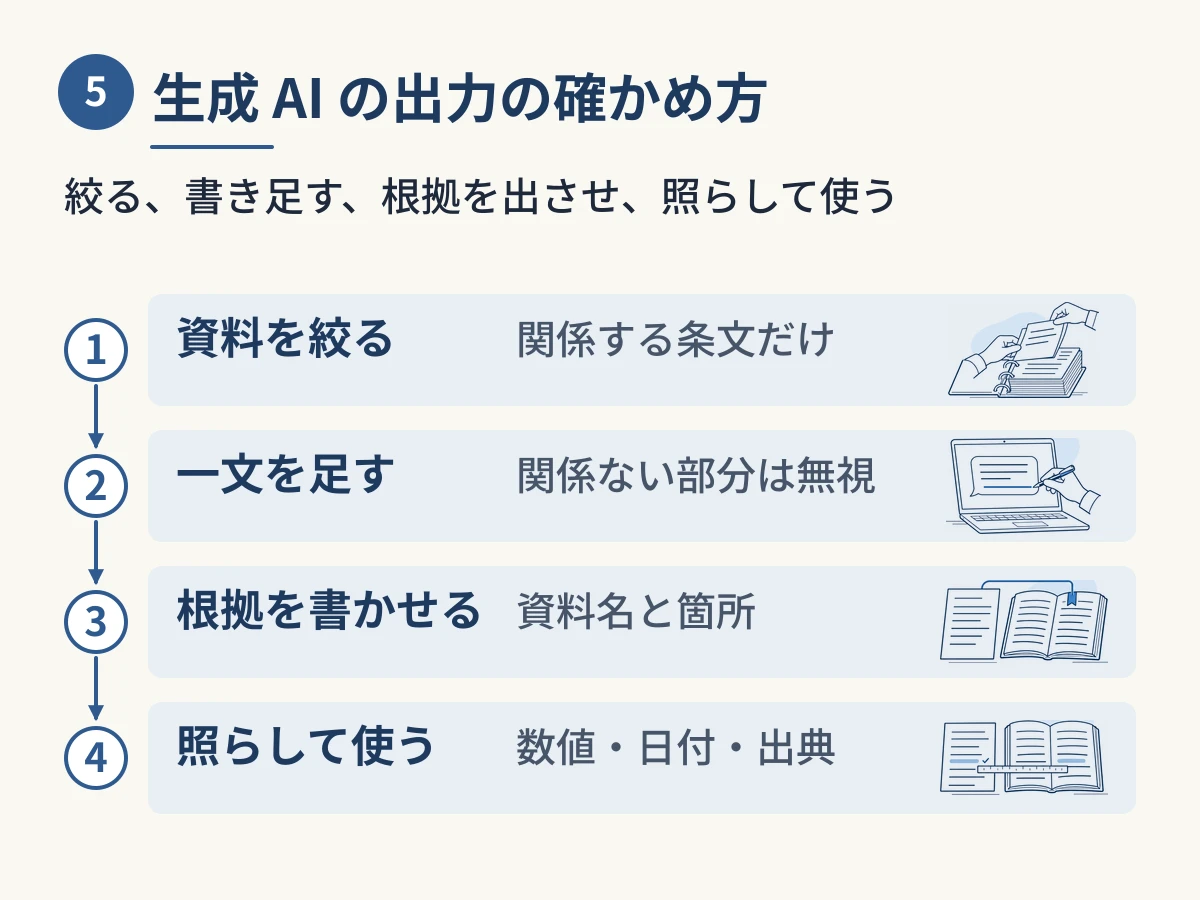
ここからは研究を踏まえた編集部の提案で、効き目を測った手順ではありません。
- 渡す資料を絞る:規程の束をまるごと貼らず、問いに関係する条文だけを渡す
- 指示に一文を足す:「渡した資料のうち、問いに関係しない部分は無視してください」と書く
- 根拠の場所を書かせる:答えに使った資料の名前と箇所を、答えと一緒に出させる
- 出力を元の資料と照らす:次の表の項目を 1 つずつ確かめ、合わないものは使わない
| 照らす項目 | 起きやすい誤り | 照らす先 |
|---|---|---|
| 数値 | 金額や日数が資料と違う | 資料の該当箇所 |
| 固有名詞 | 部署名や条文番号が無い・違う | 資料の目次や条文 |
| 日付 | 締め切りや施行日がずれる | 資料の日付の記載 |
| 出典 | 示された資料や箇所が実在しない | 資料そのもの |
最初の手順で絞っても、資料を検索して生成 AI に渡す仕組み(RAG)では、関係の無い部分が混じることがあります。
2025 年のサーベイは、RAG を主に知識の不足から来る誤りへの対策と位置づけています2。原因はモデル・データ・文脈にまたがるので、検出と抑制を段で組み合わせるべきだとする 2026 年の整理もあります3。仕組みを入れた後も、出力を照らす手順は残します。
まとめ
- 渡す文章に関係の無い情報が混じると、生成 AI の答えは崩れやすい
- 「関係の無い情報は無視して」と書くと崩れ方は和らぐが、誤りはなくならない
- 研究が測ったのは英語の算数の文章題で、社内資料での効き目はまだ分からない
- 業務では、渡す資料を絞り、指示に一文を足す
- 出力の数値・固有名詞・日付・出典は、元の資料と照らしてから使う
ご相談
生成 AI の出力を確かめる手順を社内で決めたい方はお問い合わせへ。
次に読む
参考文献
-
Large Language Models Can Be Easily Distracted by Irrelevant Context(Shi et al.、ICML 2023。要旨と、Table 2・Table 3 の code-davinci-002 のマイクロ正答率で確認)
-
Mitigating Hallucination in Large Language Models: A Capability-Oriented Survey on RAG, Reasoning, and Agentic Systems(Li et al.、arXiv 2025 年 10 月 28 日公開、2026 年 9 月 27 日改訂。要旨で確認)
-
Hallucination Detection and Mitigation in Large Language Models(Pesaranghader and Li、arXiv 2026 年 1 月 14 日公開。要旨で確認)
更新履歴
- 公開
- 更新