混同行列とは?正解率だけでモデルを選ぶと失敗する理由
見つけたいものが少ないデータでは、何も見つけないモデルでも正解率は高く出ます。混同行列で見逃しと空振りを分けて数え、適合率・再現率と損失からしきい値を決める手順と、外注先の報告で確かめる 4 つのことを説明します。
この記事の目次
見つけたいものが少ないデータでは、何も見つけないモデルでも、全体のうち予測が当たった割合(正解率)は高く出ます1。良し悪しは、予測と実際の組み合わせを 4 つに数える混同行列で、見逃しと空振りを分けて判断します2。判定の境目(しきい値)は、見逃しと空振りの損失を比べて決めます3。
こんな困りごとはありませんか
以下は仮想シナリオです。会員制サービスの担当者が、外注先から報告を受けました。「解約予測モデルの正解率は 98% です」。ところが予測どおりに声をかけても、解約する会員をほとんど拾えません1。
- 正解率が高いのに役に立たない理由を説明できない
- 報告書のどの数字を見ればよいか分からない
- 外注先に何を聞けばよいか分からない
この記事では、正解率が良く見える仕組みと、報告を受けたときに確かめる順番を紹介します。
正解率が高いのに使えないのはなぜか
見つけたいものが少ないと、全員を「続ける」と答えるだけで正解率は高くなります。
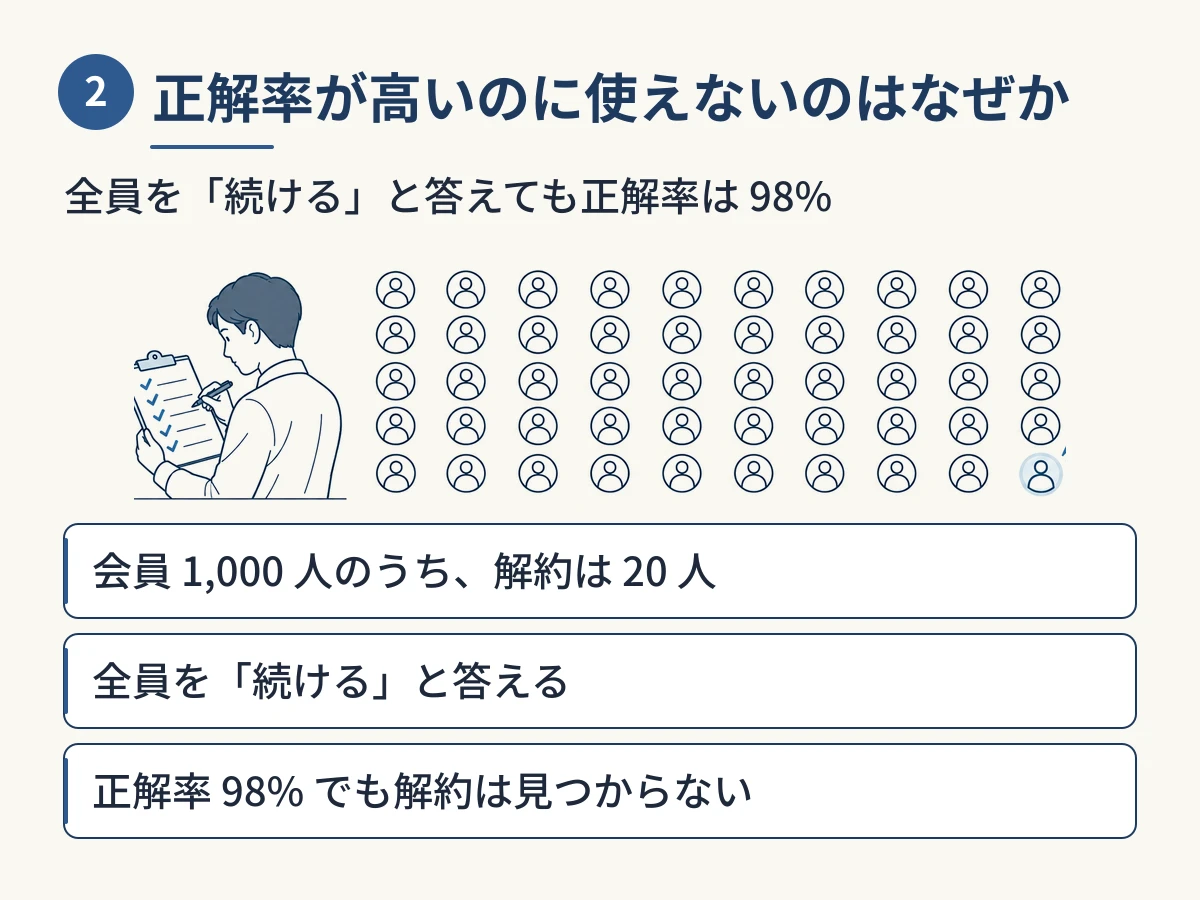 図 2 全員を「続ける」と答えても、外れるのは解約する 20 人だけ
正解率は、全体のうち予測が当たった割合です4。説明用に、会員 1,000 人のうち 20 人が 1 年で解約する例で考えます。
全員を「続ける」と答えても、正解率は 98% です。それでも、解約する会員は 1 人も見つけていません。見つけたい側が少ないデータでは、正解率は性能を実際より良く見せます1。
混同行列とは
混同行列は、予測と実際の組み合わせごとに件数を数えた表です5。
2 つに分ける予測では表は 4 マスで、解約予測では次の意味になります2。
| 実際に解約した | 実際は続けた | |
|---|---|---|
| 解約すると予測 | 見つけた(TP) | 空振り(FP) |
| 続けると予測 | 見逃した(FN) | 正しく見送った(TN) |
前の節の説明用の例では、見逃した 20 人と正しく見送った 980 人だけになります。正解率の 98% は、正しく見送った 980 人が稼いだ数字です。
適合率と再現率の違い
適合率は「解約しそう」と予測したうち当たった割合、再現率は実際に解約した人のうち拾えた割合です67。
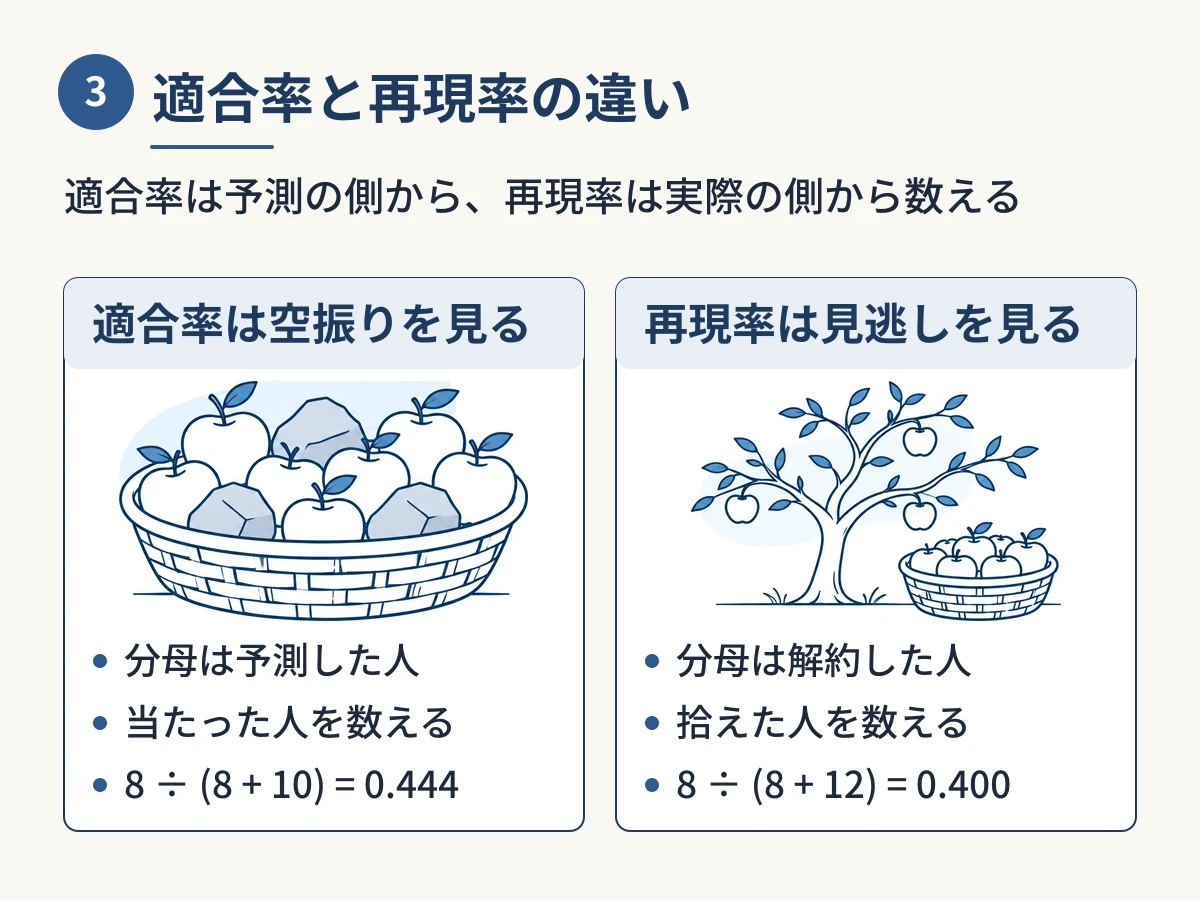
- 空振りを減らしたい:適合率を見る8
- 見逃しを減らしたい:再現率を見る
TP などを数える前提として、多くのモデルは会員ごとに解約の確率を 0〜1 で出します9。確率が境目(しきい値)以上なら「解約しそう」と判定します。
ここからは説明用のモデルで考えます。しきい値 0.5 で判定した結果は次のとおりです。
- 見つけた 8 人、空振り 10 人、見逃した 12 人
- 適合率は 8 ÷ (8 + 10) = 0.444
- 再現率は 8 ÷ (8 + 12) = 0.400
Excel なら、件数を B2(見つけた)・B3(空振り)・B4(見逃した)に置きます。=B2/(B2+B3) と =B2/(B2+B4) で同じ値が出ます。
しきい値の決め方
しきい値を下げると、正解率は下がっても損失の合計が小さくなることがあります。
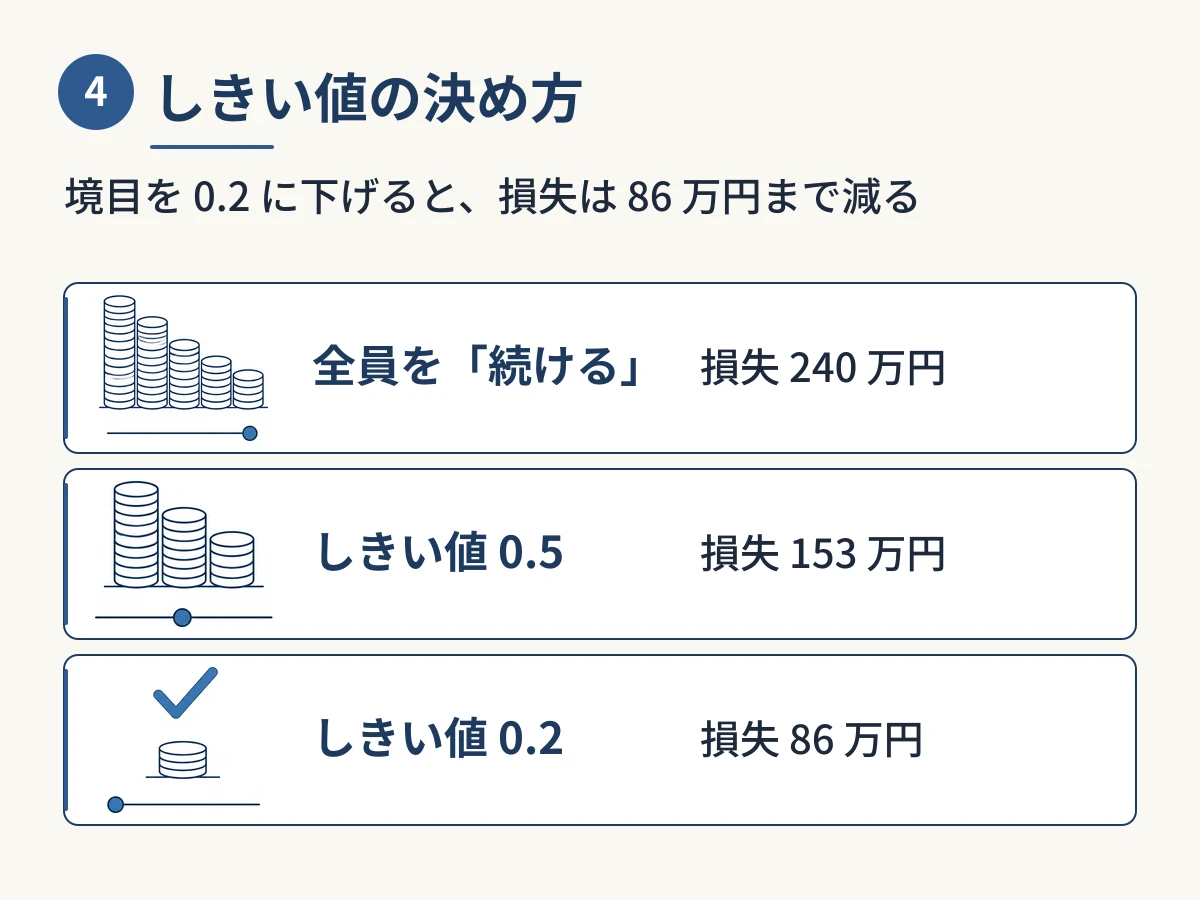 図 4 しきい値を 0.2 に下げると、正解率は下がるが損失は小さい
機械学習ライブラリの scikit-learn は、確率を出すモデルでは既定で 0.5 を境に判定します9。この既定は、多くの業務に合いません3。業務では、誤りの損失に合わせて境目を決めます。
説明用に、次のように仮定します。
- 見逃した解約 1 人の損失は 12 万円(1 年分の会費などから見積もる)
- 声かけ 1 人の費用は 5,000 円(担当者の手間と特典)
- 声をかけた解約予定者は引き止められる
この式で 3 つの案を比べます。
| 案 | 見逃し / 声かけ | 損失 | 正解率 |
|---|---|---|---|
| 全員を「続ける」 | 20 人 / 0 人 | 240 万円 | 98.0% |
| しきい値 0.5 | 12 人 / 18 人 | 153 万円 | 97.8% |
| しきい値 0.2 | 4 人 / 76 人 | 86 万円 | 93.6% |
正解率が一番低いしきい値 0.2 で、損失が一番小さくなります。境目を下げると、空振りは増え、見逃しは減ります10。見逃しの損失が大きい業務では、空振りを許して見逃しを減らす案が有力です11。
実際には、引き止められない人もいます。自社で使うときは、引き止めの成功率を掛けて見積もります。
見積もった損失が最小になるしきい値は、検証用のデータで選べます12。選んだのと同じデータで損失を測ると、良く見えます。別の期間のデータでも確かめます。
報告を受けたら確かめる 4 つのこと
高い正解率を聞いたら、数字の前提を順に確かめます。
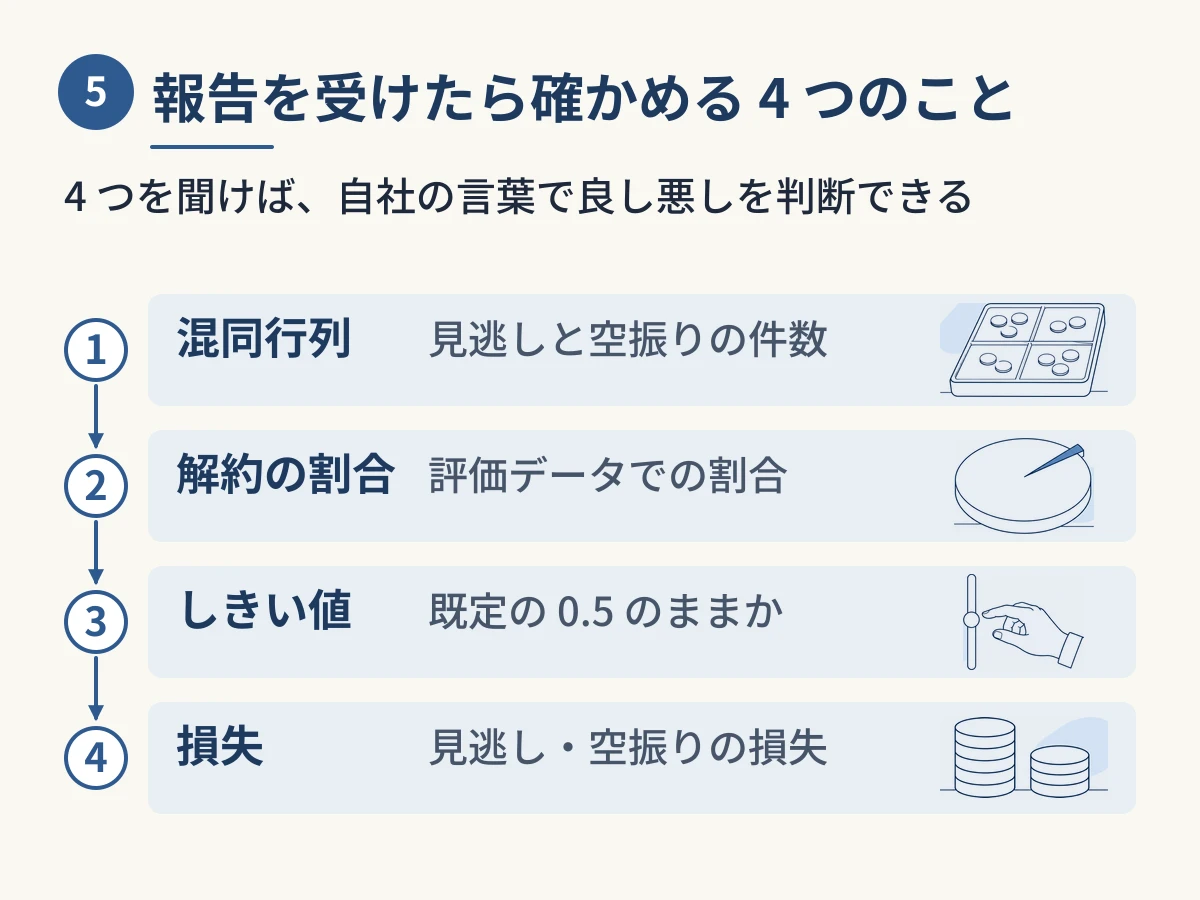 図 5 4 つを聞けば、モデルの良し悪しを自社の言葉で判断できる
- 混同行列を見せてもらう:見逃しと空振りの件数を確かめる
- 評価データの解約の割合を聞く:解約者が多いデータで測るほど、適合率は高く出る
- しきい値を聞く:既定の 0.5 のままか、損失から決めたかを確かめる9
- 見逃しと空振りの損失を伝える:その比に合わせて、しきい値を選び直してもらう
確認事項 2(評価データの解約の割合)の例を、説明用の数字で示します。しきい値 0.5 のモデルを、解約者が半数の 1,000 人で測ったとします。再現率と、続ける人の空振りの割合は変えません。
| 評価データ | 見つけた | 空振り | 適合率 |
|---|---|---|---|
| 解約者 20 人 / 1,000 人 | 8 人 | 10 人 | 0.444 |
| 解約者 500 人 / 1,000 人 | 200 人 | 約 5 人 | 0.975 |
実際の会員より解約が多いデータで測った適合率は、実際に使うと下がります。
適合率のほかに、ROC 曲線と AUC(しきい値を動かしたときの成績の動きを描いた図とその下の面積)が報告書に載ることもあります。ROC 曲線は、しきい値を動かしたときの再現率と空振りの割合の動きを描いた図です13。AUC はその下の面積で、モデル同士を比べるときに使います。ROC 曲線だけでは、どのしきい値で使うかは決まりません14。
まとめ
- 見つけたいものが少ないと、何も見つけないモデルでも正解率は高く出る
- 混同行列で、見逃しと空振りを分けて数える
- 空振りを減らすなら適合率、見逃しを減らすなら再現率を見る
- しきい値は、見逃しと空振りの損失を比べて決める
- 報告を受けたら、混同行列・評価データの割合・しきい値・損失を確かめる
ご相談
外注した予測モデルの評価を見直したい方はお問い合わせへ。
次に読む
参考文献
-
Metrics and scoring: quantifying the quality of predictions(scikit-learn 公式ドキュメント。不均衡なデータで正解率が実際より高く見えること)
-
Metrics and scoring: quantifying the quality of predictions(scikit-learn 公式ドキュメント。見つけた・空振り・見逃し・正しく見送ったの用語)
-
Tuning the decision threshold(scikit-learn 公式ドキュメント。既定のしきい値が多くの場面で理想的でないこと)
-
Metrics and scoring: quantifying the quality of predictions(scikit-learn 公式ドキュメント。正解率の定義)
-
Metrics and scoring: quantifying the quality of predictions(scikit-learn 公式ドキュメント。混同行列の定義)
-
Metrics and scoring: quantifying the quality of predictions(scikit-learn 公式ドキュメント。適合率の定義)
-
Metrics and scoring: quantifying the quality of predictions(scikit-learn 公式ドキュメント。再現率の定義)
-
Metrics and scoring: quantifying the quality of predictions(scikit-learn 公式ドキュメント。適合率と再現率の直感的な意味)
-
Tuning the decision threshold(scikit-learn 公式ドキュメント。既定のしきい値 0.5)
-
Tuning the decision threshold(scikit-learn 公式ドキュメント。しきい値を下げると空振りが増えること)
-
Tuning the decision threshold(scikit-learn 公式ドキュメント。見逃しの損失が大きいときはしきい値を下げること)
-
Tuning the decision threshold(scikit-learn 公式ドキュメント。業務の指標を最大にするしきい値を選ぶ方法)
-
Metrics and scoring: quantifying the quality of predictions(scikit-learn 公式ドキュメント。ROC 曲線の定義)
-
Tuning the decision threshold(scikit-learn 公式ドキュメント。しきい値を変えても ROC 曲線は変わらないこと)
更新履歴
- 公開
- 更新