ロジスティック回帰で解約の確率を出し、係数を読む方法
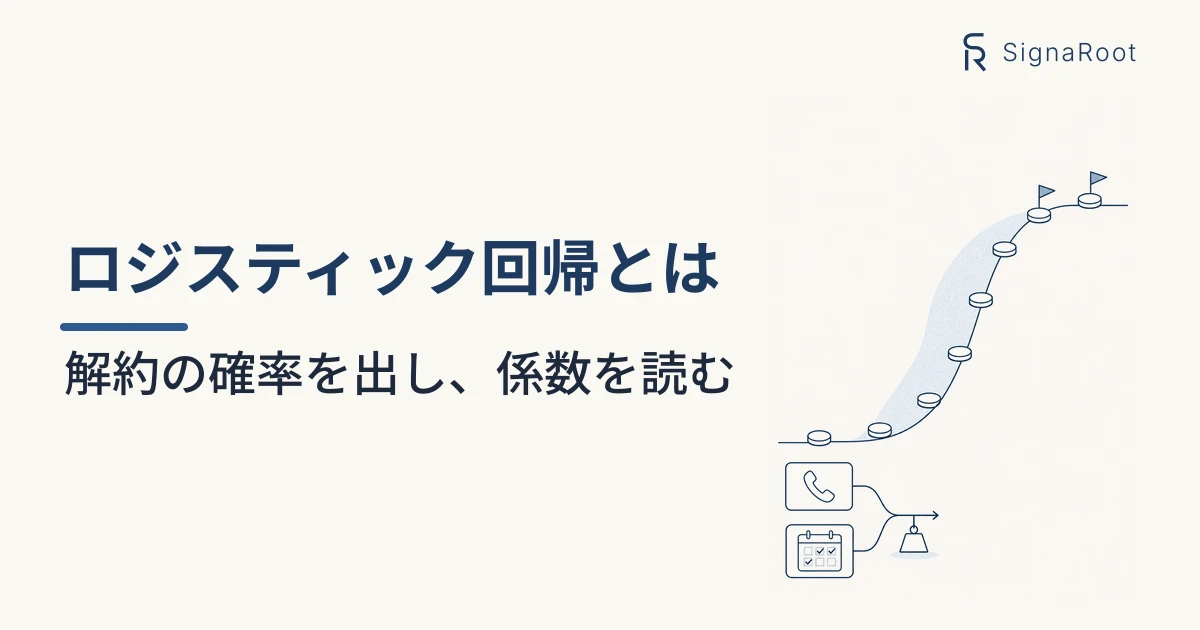
ロジスティック回帰は、顧客の情報に係数を掛けて足し、S 字の関数で解約の確率に変える仕組みです。架空の顧客で確率を手計算して Excel の式で再現し、しきい値の決め方と、係数を原因ではなく関係の目安として読む理由を説明します。
この記事の目次
ロジスティック回帰は、結果が 2 つに分かれる出来事の確率を計算する予測の仕組みです1。入力ごとに掛ける重み(係数)で顧客の情報を足し合わせ、S 字の関数で確率に変えます2。声をかける範囲は件数の上限か業務の損得で決め、係数は原因ではなく関係の目安として読みます。
こんな困りごとはありませんか
 図 1 解約しそうな顧客を前もって見つけて、早めに連絡したい
以下は仮想シナリオです。月額契約のサービスで営業を担当しています。解約しそうな顧客を前もって見つけて、早めに連絡したいと考えています。問い合わせが増えた顧客や、ログインが減った顧客が気になっています。ただ、全員に連絡する時間はありません。
- 解約する・しないは前もって分からないので、どのくらい起きそうかを数字で知りたい
- 問い合わせの多さや利用の少なさが、解約にどれだけ関わっているのかを知りたい
- 全員には連絡できないが、どこまでの顧客に声をかければ割に合うかの線を引けない
この記事では、顧客ごとの解約の確率を Excel で計算する手順と、確率の元になる係数の読み方、声をかける範囲の決め方を紹介します。
ロジスティック回帰とは
ロジスティック回帰は、「解約する・しない」のように結果が 2 つに分かれる出来事の確率を出す仕組みです1。
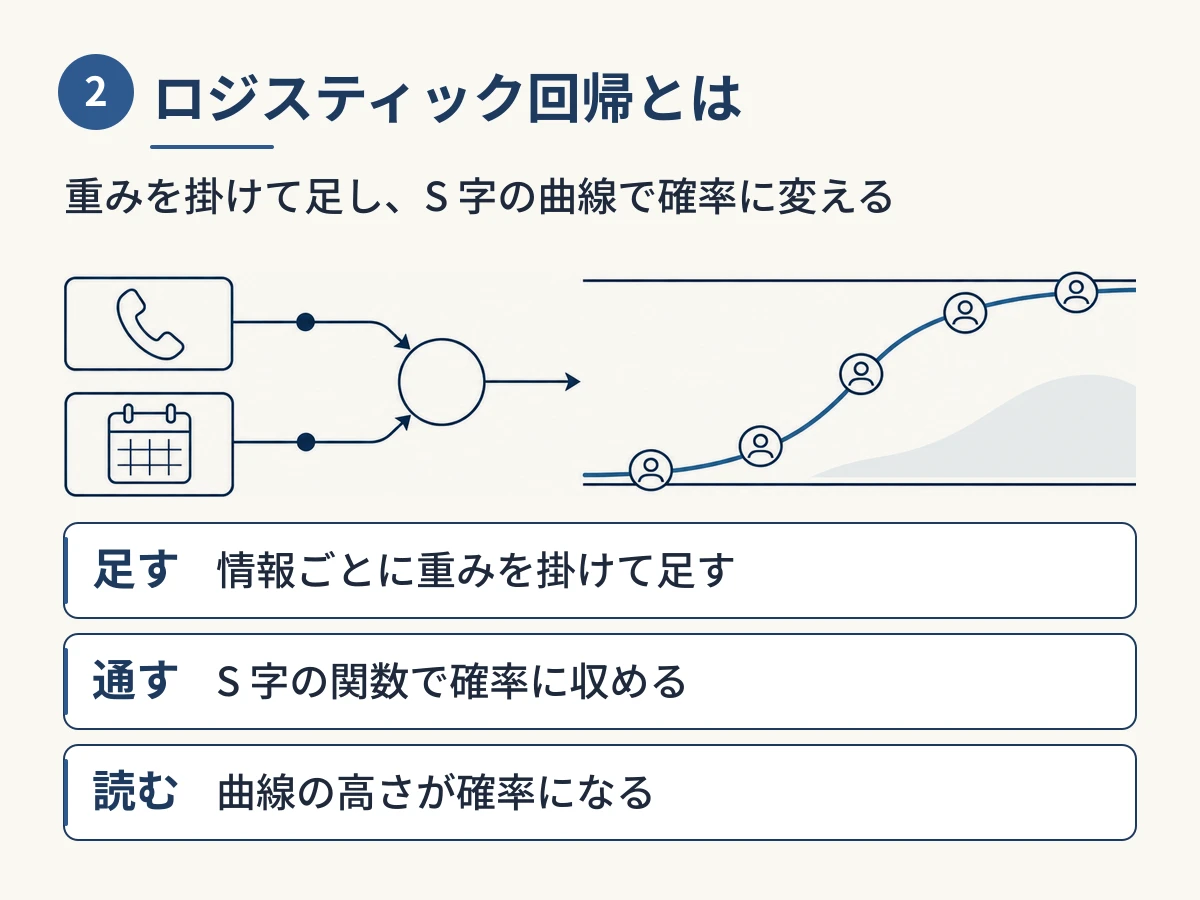
計算は 2 段階です。まず顧客の情報ごとに重みを掛けて足し、値 z を作ります。次に z をシグモイド関数(どんな数でも 0 から 1 のあいだの値に変える S 字の関数)に通します2。
ここで、p は解約する確率です。x₁ と x₂ は説明用に選んだ入力で、直近 3 か月の問い合わせ回数と月のログイン日数とします。b₁ と b₂ は入力ごとの重み(係数)、b₀ は入力がどれも 0 のときの出発点(切片)です2。e は定数で、Excel では EXP 関数で計算します。
例えば z が −2 なら 0.119、0 なら 0.5、2 なら 0.881 です。z が大きいほど確率は 1 に近づきます3。
係数は、過去の記録から決めます(学習)。決まった係数を新しい顧客に当てはめて確率を出すのが予測です。
回帰と呼ばれるのは、確率という連続した値を出すからです1。その確率に境目を置いて初めて「解約する・しない」の分類になります4。
確率を手で計算する
係数が決まっていれば、解約の確率は Excel の短い式で顧客ごとに出せます。
説明用に、係数を b₀ = −1.0、b₁ = 0.8、b₂ = −0.1 と置きます。実際の係数は過去の記録から分析用のプログラムで学習し、Excel は決まった係数を当てはめる計算に使います。
| 顧客 | 問い合わせ/ログイン | z → 確率 | 実際 |
|---|---|---|---|
| A | 4 回/2 日 | 2.0 → 0.88 | 解約 |
| B | 3 回/5 日 | 0.9 → 0.71 | 解約 |
| C | 0 回/20 日 | −3.0 → 0.05 | 継続 |
| D | 2 回/4 日 | 0.2 → 0.55 | 解約 |
| E | 1 回/15 日 | −1.7 → 0.15 | 継続 |
| 顧客 | 問い合わせ/ログイン | z → 確率 | 実際 |
|---|---|---|---|
| F | 2 回/10 日 | −0.4 → 0.40 | 継続 |
| G | 3 回/8 日 | 0.6 → 0.65 | 継続 |
| H | 1 回/3 日 | −0.5 → 0.38 | 解約 |
| I | 0 回/6 日 | −1.6 → 0.17 | 継続 |
| J | 5 回/12 日 | 1.8 → 0.86 | 継続 |
表の顧客 D なら、z は −1.0 + 0.8 × 2 − 0.1 × 4 = 0.2 です。これをシグモイド関数に通すと、1 ÷ (1 + e^−0.2) = 0.55 になります2。例えば 0.55 は、顧客 D と同じ問い合わせ回数とログイン日数の顧客が 100 人いれば、およそ 55 人が解約する見込みという意味です。この見込みが実際の割合と合うかは、確認用のデータで確かめます。
Excel では、B 列に問い合わせ回数、C 列にログイン日数を入れます。2 行目に =1/(1+EXP(-(-1+0.8*B2-0.1*C2))) と書き、下へコピーします。顧客 D の行が 0.55 になれば、式は合っています。
係数とオッズの読み方
係数が一定の倍率で動かすのはオッズ(起きる確率と起きない確率の比)で、確率の増え方は顧客ごとに違います。
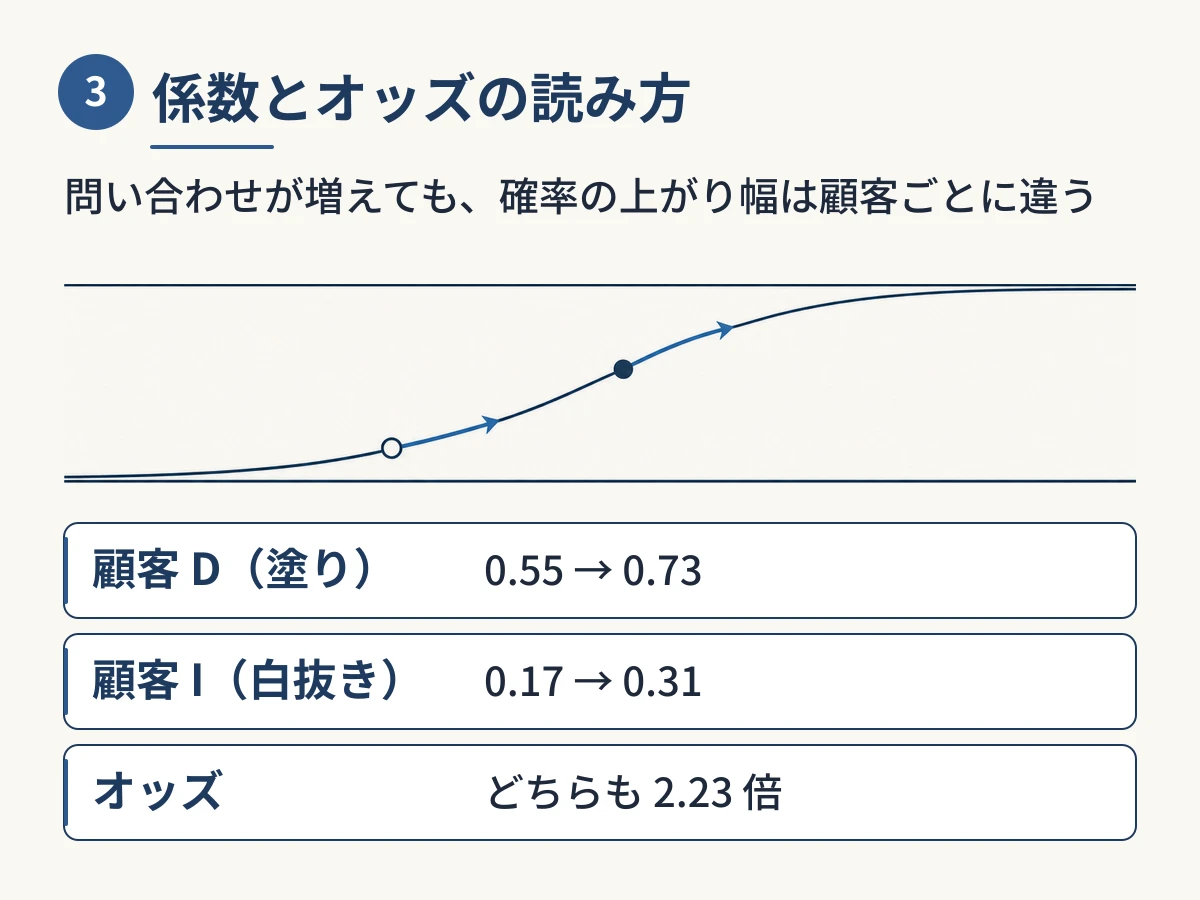 図 3 同じ 1 回の問い合わせでも、確率の上がり幅は顧客ごとに違う
説明用の係数のまま式を変形すると、オッズは次の関係になります。
ここで、分子の p は解約する確率、分母は続ける確率です。ログイン日数が同じまま問い合わせが 1 回増えると、z は 0.8 増え、オッズは e の 0.8 乗(約 2.23)倍になります。逆にログイン日数が 1 日増えると、z は 0.1 減り、オッズは e の −0.1 乗(約 0.90)倍になります。この係数のままなら、問い合わせ 1 回分の動きは、ログイン 8 日分の減少とほぼ同じ大きさです。
同じ 1 回の増加を確率で見ると、顧客 D は 0.55 から 0.73 へ 0.18 上がります。顧客 I は 0.17 から 0.31 へ 0.14 上がります。上がり幅は、元の確率しだいです。
ここまでの倍率は、係数の値そのものに頼っています。その係数の値は、係数が大きくなりすぎないように抑える工夫(正則化)の強さで変わります5。scikit-learn(機械学習のライブラリ)は何も指定しなくても正則化をかけるので6、設定を変えていなくても係数は抑えられた値になっています。分析担当に係数を頼むときは、正則化の設定も一緒に記録してもらいます。
係数の大きさは、入力の単位でも変わります。例えば金額を円で入れるか万円で入れるかで、係数は 1 万倍違います。回数に加えて金額のような桁の大きい入力を使うときは、同じくらいの幅に揃えてから使うと計算が安定します7。揃えた後の係数は元の単位あたりの値ではなくなるため、オッズも揃えた単位で読みます。
入力どうしが強く連動しているときも、係数は動きます。scikit-learn は、最小二乗法の線形回帰で入力どうしが強く連動すると、係数の推定がぶれやすいと説明しています8。ロジスティック回帰も同じ線形のモデルなので、係数が動きやすいと考えられます。そのため、連動している 2 つの入力は片方の係数だけを見ず、2 つを合わせて解約との関係を読みます。
係数は過去の記録で、どの入力が解約と一緒に動いたかを表すだけです。例えば、不満を抱えた顧客が問い合わせを増やし、その不満で解約しているのなら、問い合わせを減らしても解約は減りません。声をかけると解約が減るかどうかは、声をかける顧客をくじで分け、声をかけた組とかけなかった組の解約を比べるなど、別の方法で確かめます。
確率を判定に変える
連絡できる件数が決まっているなら、確率の高い順に上から声をかけます。件数に余裕があれば、声をかける境目(しきい値)を業務の損得で決めます。
例えば表の 10 人で 3 人までなら、A・J・B に声をかけ、解約した 4 人のうち 2 人に届きます。
件数ではなく確率の境目で決めるときは、どこに置くかを選びます。scikit-learn は、既定では確率 0.5 を境に判定します9。見逃しの損が大きい業務では、しきい値を下げる方が良い場合があります10。
先ほどの架空の 10 人で、しきい値 0.3・0.5・0.7 の費用を比べます。説明用に、声かけ 1 件の手間を 5,000 円、見逃した解約 1 件の損を 30,000 円と仮定します。声をかけた顧客は解約を防げたものとして数えます。
| しきい値 | 声をかける | 見逃した解約 | 費用の合計 |
|---|---|---|---|
| 0.3 | 7 人 | 0 人 | 35,000 円 |
| 0.5 | 5 人 | 1 人 | 55,000 円 |
| 0.7 | 3 人 | 2 人 | 75,000 円 |
この仮定では、見逃しが 0 人になるしきい値 0.3 の費用が一番小さくなります。ただし、解約するはずだった顧客のうち声かけで引き止められるのが 3 人に 1 人より少なければ、順位は逆になり、しきい値 0.7 の費用が一番小さくなります。
どのしきい値を選んでも、顧客ごとの確率は同じで、変わるのは声をかけるかどうかの判定だけです11。実際の業務では、しきい値は、学習に使っていないデータで比べて選びます。見逃しと空振りを数えてしきい値を選ぶ手順は、混同行列で見抜く、正解率が高いのに使えないモデルで説明しています。
自社のデータで試す前に
表の形を整え、学習に使っていない確認用のデータで成績を確かめます。
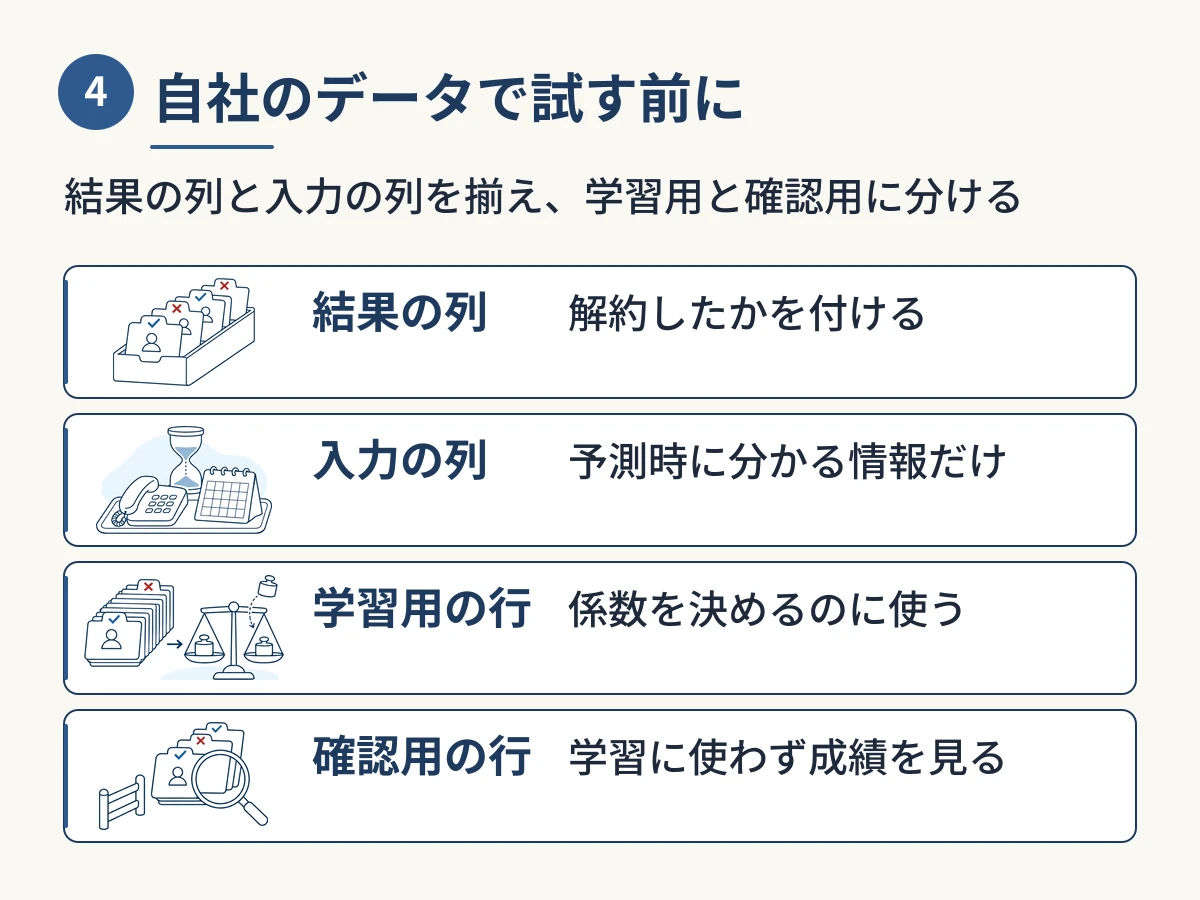
- 結果の列:過去の契約ごとに「解約したか」を付ける
- 入力の列:問い合わせ回数など、予測する時点で分かっている情報だけを使う
- 学習用と確認用:データを分け、確認用で予測がどれだけ当たるかを見る12
確認用のデータに学習用と同じ顧客が混ざっていたら、確認用から除きます。公正な評価は、新しい例でしか成り立ちません13。
確認用のデータは、手法を比べるときにも使います。結果が 2 つに分かれる予測には決定木などの手法もあり、どれが合うかは確認用のデータで比べて決めます。
まとめ
- ロジスティック回帰は、重み付きの合計をシグモイド関数に通して解約の確率を出す
- 係数が決まれば、確率は Excel の
EXP(を使った短い式で顧客ごとに出せる - 係数が一定の倍率で動かすのはオッズで、原因の大きさではなく関係の目安として読む
- 声をかける範囲は、件数の上限があれば確率の高い順、無ければ業務の損得で決める
- 最初の一歩は、過去の契約に解約の印と入力の列を数本付けた表を作り、係数の学習を分析担当に頼むこと
ご相談
自社の契約データで解約の確率を出してみたい方はお問い合わせへ。
次に読む
参考文献
-
Logistic Regression(Google Machine Learning Crash Course。確率を予測する回帰モデルとしての定義)
-
Linear Models(scikit-learn 公式ドキュメント。重み付き合計をシグモイド関数で確率に変える式)
-
Linear Models(scikit-learn 公式ドキュメント。線形予測子から確率、判定へ進む構造)
-
Classification(Google Machine Learning Crash Course。確率を出すモデルを、しきい値で分類に変えること)
-
Linear Models(scikit-learn 公式ドキュメント。正則化の強さを C で変えること)
-
Linear Models(scikit-learn 公式ドキュメント。ロジスティック回帰に既定で正則化がかかること)
-
Linear Models(scikit-learn 公式ドキュメント。入力の尺度が揃っていないと計算の性能が落ちること)
-
Linear Models(scikit-learn 公式ドキュメント。最小二乗法では入力どうしの相関が強いと係数の推定が不安定になる)
-
Tuning the decision threshold for class prediction(scikit-learn 公式ドキュメント。既定のしきい値 0.5)
-
Tuning the decision threshold for class prediction(scikit-learn 公式ドキュメント。見逃しの損が大きいときにしきい値を下げること)
-
Tuning the decision threshold for class prediction(scikit-learn 公式ドキュメント。しきい値を変えても確率は変わらないこと)
-
Datasets: Dividing the original dataset(Google Machine Learning Crash Course。データを学習用と確認用に分けること)
-
Datasets: Dividing the original dataset(Google Machine Learning Crash Course。確認用から学習用と重なる例を除くこと)
更新履歴
- 公開
- 更新